Архитектура и доступ
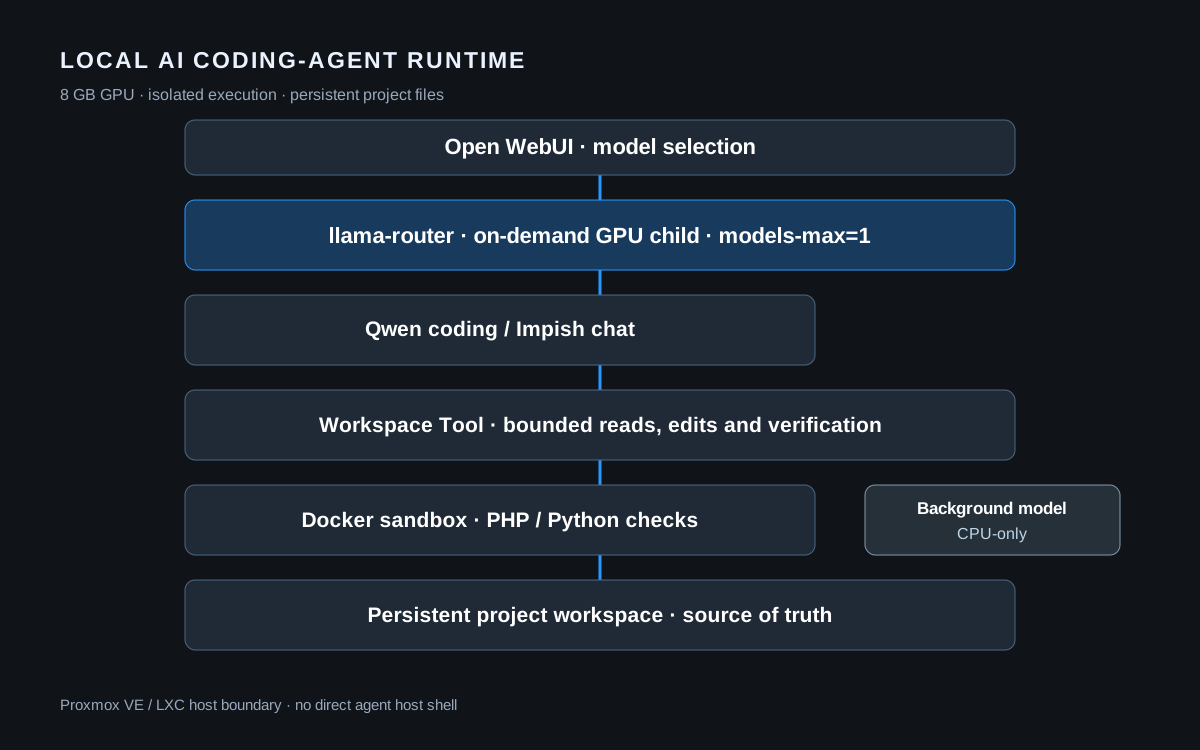
Связал Proxmox VE, LXC, Docker и постоянную рабочую папку. Агент выполняет команды в sandbox без прямого shell-доступа к хосту.
Можно переключить сайт на светлую IT-палитру: белый фон, графитовый текст и холодный синий акцент.
AI Integration · Agent Tooling · Local LLM Systems
Спроектировал локальную среду, в которой AI-агент работает с PHP- и Python-проектами: находит нужный код, выполняет команды в изолированном окружении, вносит ограниченную правку и проверяет результат перед завершением задачи.
Моя зона ответственности: архитектура, интеграция инструментов, правила редактирования, проверки, настройка модели и маршрутизация локальных моделей.
Результаты внутренних испытаний 13–14 сентября 2026 года.
01 / ЗАДАЧА И РЕЗУЛЬТАТ
Мне нужна была локальная среда, в которой модель может работать с реальным репозиторием, но её действия ограничены рабочей папкой и инструментами проверки. Я связал локальный inference, доступ к коду, выполнение команд в Docker sandbox и проверку результата в один рабочий процесс для PHP и Python. Это внутренний инженерный проект.
02 / МОЙ ВКЛАД
Связал Proxmox VE, LXC, Docker и постоянную рабочую папку. Агент выполняет команды в sandbox без прямого shell-доступа к хосту.
Настроил целевое чтение файлов и правки по актуальному состоянию; запретил полную перезапись существующих файлов и бесконечные повторные попытки.
Встроил PHP/Python lint, статический анализ и тесты в завершение задачи. После повторно отклонённой правки агент останавливает изменения.
Профилировал Qwen3.6-35B-A3B на CPU/GPU и добавил llama-router: GPU загружает нужную модель по запросу, фоновые задачи идут через CPU-модель.
03 / РАБОЧИЙ СЦЕНАРИЙ
Зафиксированный PHP-сценарий проходит от чтения релевантного участка репозитория до правки, проверок и завершения. Для Python отдельно проверено восстановление повреждённого файла.
Находит нужный участок кода и читает актуальную версию файла.
Изменяет связный фрагмент, не перезаписывая весь существующий файл.
Запускает проверки проекта: lint, статический анализ и тесты для PHP; compile/Ruff для Python.
Фиксирует результат после PASS. При повторно отклонённой правке останавливает дальнейшие изменения.
04 / ИЗМЕРЕНИЯ
Измерения двух внутренних конфигураций от 13–14 сентября 2026 года. Результаты benchmark и наблюдения в coding-запросах указаны отдельно.
| Показатель | До | Результат | Условия измерения |
|---|---|---|---|
| Контекст | 28 672 токена | 140 800 токенов (4,91×) | Протестированный запрос; на 143 872 токенах возник CUDA OOM. |
| Cold prefill | 111,05 tok/s · uBatch 128 | ~274,6–276,2 tok/s · uBatch 512 | ~275,6 tok/s на cold request из 8 117 токенов; 2,48× в этом sweep. |
| Decode | 26,11 tok/s · без DFlash | 32,20 tok/s · DFlash n=2 | Выигрыш ~23% в benchmark; скорость не гарантируется для каждого запроса. |
| Coding turns | — | ~30–33 tok/s | Наблюдалось после настройки в репрезентативных запросах. |
| Prefix cache | — | ~97–98% reuse | Только в representative final passes; зависит от сессии и переключения модели. |
05 / АРХИТЕКТУРА
06 / ИНЖЕНЕРНЫЕ РЕШЕНИЯ
Сохранил q8_0 K/V и протестированный предел 140 800 токенов. Запрос на 143 872 токена выявил границу по памяти.
uBatch 512 ускорил prefill; значения 544/576 не дали значимого выигрыша. n-cpu-moe=36 использует меньше VRAM без потери скорости относительно 34.
DFlash n=2 улучшил decode в серии тестов; n=4 и n=8 оказались хуже в зафиксированных измерениях.
07 / МАТЕРИАЛЫ
PDF содержит схему, конфигурацию, измерения и результаты внутренних сценариев от 13–14 сентября 2026 года. Обезличенный ход выполнения задачи и результаты проверок могу показать на интервью.
Технический кейс (PDF, RU · 220 КБ) ↗Отдельный пример AI-функции в коммерческом продукте — RAG FAQ для поддержки X-BOT. Смотреть X-BOT →
08 / ПРИМЕНЕНИЕ ОПЫТА
AI/LLM integration · Agent tooling · Workflow automation · PHP/Python verification · Local inference · Model routing
Связаться по поводу роли →